Mis à jour le 12 octobre 2026
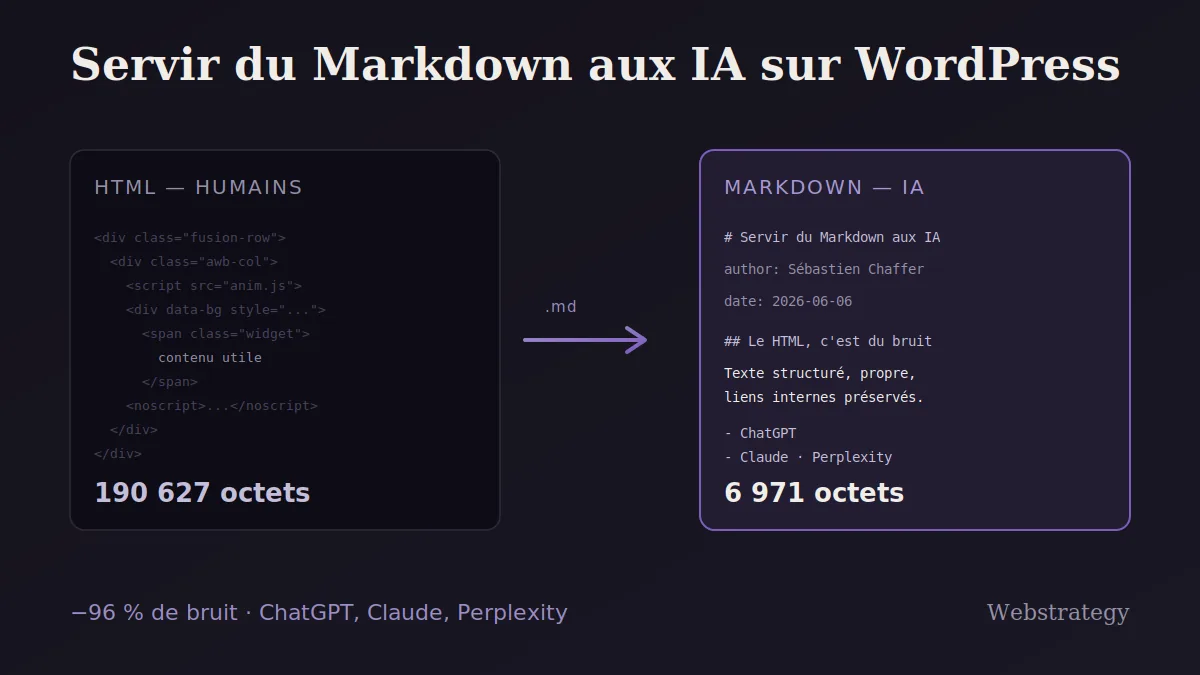
Servir du Markdown aux IA consiste à détecter un crawler d’IA (GPTBot, ClaudeBot, PerplexityBot) et à lui renvoyer une version Markdown propre de la page, au lieu du HTML complet. Sur mon site, un article passe de 190 627 octets à 6 971 octets. C’est une optimisation de confort pour les robots, pas un levier prioritaire de SEO ou de GEO.
Depuis un an et demi, le trafic organique de mes clients se déplace sans faire de bruit. Les clics Google baissent sur certaines requêtes, mais leur nom continue d’apparaître ailleurs : dans les réponses de ChatGPT, dans les résumés de Perplexity, dans les AI Overviews de Google. L’audience existe toujours, elle ne passe simplement plus par le site. Elle consomme la réponse directement dans l’IA.
Ce déplacement est désormais mesurable en France. Depuis le 22 juillet 2026, j’ai relevé le déclenchement et la citation des AI Overviews sur un portefeuille client : le bloc apparaît sur près de six requêtes sur dix et ne cite jamais le site.
La question a donc changé. Ce n’est plus seulement « est-ce que je suis bien classé sur Google », c’est aussi « est-ce que mon contenu est correctement compris et cité par les IA quand elles répondent sur mon domaine ». Et là, un problème technique se pose.
Pourquoi servir du Markdown aux IA plutôt que du HTML ?
Parce qu’une page WordPress bâtie avec un page builder contient surtout du code, pas du texte. Le Markdown retire ce bruit et ne garde que le titre, la hiérarchie et le contenu. L’IA a moins de nettoyage à faire avant d’extraire l’information, ce qui réduit le risque de mauvaise interprétation.
Prenez une page construite avec Avada, Elementor ou Divi. Côté visiteur, elle s’affiche très bien. Côté crawler IA, c’est une autre histoire : des centaines de div imbriquées, du JavaScript d’animation, des scripts d’analytics, des widgets de chat, du CSS inline. Le contenu réellement utile représente souvent moins de 10 % du document. Quand GPTBot ou ClaudeBot ingère cette page, il doit faire un gros travail de débruitage avant d’en extraire l’information.
Qu’est-ce que le standard llms.txt ?
llms.txt est une proposition publiée en septembre 2024 par Jeremy Howard sur llmstxt.org. Elle suggère un fichier Markdown à la racine du site qui liste les pages importantes, et des copies Markdown des pages accessibles en ajoutant .md à leur URL.
Le principe ressemble au robots.txt ou au sitemap XML, mais pour les modèles de langage. La documentation de plusieurs éditeurs d’IA (OpenAI, Anthropic, Gemini) publie déjà un llms.txt, et des plugins comme Yoast SEO ou AIOSEO savent le générer, d’après la page du standard. Servir du Markdown aux IA s’inscrit dans cette logique, mais sans dépendre d’un fichier que les crawlers ne lisent pas toujours.
Il faut rester lucide sur l’adoption. En avril 2025, John Mueller (Google) avait comparé le llms.txt à la balise meta keywords et indiqué qu’aucun service d’IA n’avait dit l’utiliser, selon Search Engine Journal. Je traite donc cette couche comme un complément technique, pas comme une promesse de citations.
Que voit une IA sur mon site ?
Une IA reçoit sur mon site une version Markdown de chaque article, servie uniquement aux crawlers identifiés. Vous pouvez la consulter vous-même en ajoutant .md à l’URL de n’importe quel article. Le visiteur humain, lui, continue de recevoir le HTML complet.
Le plus simple, c’est de vous montrer sur mon propre site. Cette page que vous lisez existe en deux versions. Celle que votre navigateur affiche, en HTML complet. Et une version Markdown servie uniquement aux crawlers IA.
Les chiffres sont parlants. Sur un de mes articles, la version HTML servie aux humains pèse 190 627 octets. La version Markdown servie à ClaudeBot pour le même contenu : 6 971 octets. Une réduction de 96 %. L’IA reçoit le titre, l’auteur, la date, puis le texte structuré en Markdown propre, avec les liens internes préservés et les titres hiérarchisés. Plus de div, plus de scripts, plus de bruit. Juste l’information. C’est une base pour la citabilité de votre contenu par les IA, qui reste surtout une question de contenu.
Le mécanisme repose sur la détection du User-Agent. Quand un crawler identifié comme une IA visite une URL normale, le serveur lui retourne le Markdown au lieu du HTML. Et pour vérifier que tout se tient côté SEO, chaque réponse Markdown envoie un en-tête noindex et un canonical qui renvoie vers la version HTML. Pas de duplicate content : le HTML reste la source d’autorité pour Google, le Markdown sert seulement les IA.
Comment mon plugin sert le Markdown, concrètement ?
J’ai construit ce mécanisme dans un plugin, WS Markdown for Bots, qui combine trois modes activables séparément : le suffixe .md, la détection automatique des crawlers, et la génération des fichiers llms.txt et llms-full.txt conformes au standard.
- Suffixe .md : donne accès à la version Markdown de n’importe quelle URL.
- Détection des crawlers : sert le Markdown sans intervention.
- llms.txt et llms-full.txt : un index des pages importantes et le contenu complet agrégé.
La détection couvre plus de trente crawlers IA : GPTBot et ChatGPT-User côté OpenAI, ClaudeBot côté Anthropic, PerplexityBot, Google-Extended (le crawler d’entraînement IA, distinct de Googlebot), Applebot-Extended, Bytespider, et beaucoup d’autres. La liste est éditable : on peut ajouter ses propres patterns ou en exclure. La question du cloaking et de la légitimité de cette différenciation est analysée en détail dans un article dédié.
La conversion HTML vers Markdown se fait en PHP natif, sans service tiers ni dépendance externe. Un point qui m’a demandé du soin : les shortcodes sont pré-rendus avant la conversion. Concrètement, tout ce qui est construit avec un page builder (Avada, Elementor, Divi, Gutenberg) est traité sur son rendu HTML final, pas sur le code brut de l’éditeur. C’est ce qui fait que ça marche sur des sites réels et pas seulement sur du contenu Gutenberg propre.
Côté performance, chaque conversion est mise en cache vingt-quatre heures via les transients WordPress, et le cache est invalidé dès qu’un article est modifié. La conversion ne coûte donc qu’une fois par jour et par URL, quel que soit le nombre de passages de bots. Et sur une requête HTML normale, le plugin ne s’exécute pas du tout : zéro surcoût pour vos visiteurs.
Pour qui est-ce utile, et que révèle le suivi des bots ?
C’est surtout utile aux sites dont le contenu technique est enfoui sous du code : documentation logicielle, e-commerce technique, sites média ou d’expertise. Le suivi des passages de bots, lui, apporte une information concrète sur l’intérêt que les IA portent à vos pages.
Le plugin enregistre chaque passage de bot dans un tableau de bord. C’est souvent une révélation pour mes clients : ils découvrent quelle IA s’intéresse à leur contenu, et surtout quelles pages. Régulièrement, ce n’est pas la homepage commerciale qui attire le plus de ClaudeBot, mais un article technique de fond. L’information change la façon de prioriser le contenu, et complète bien une stratégie LLM SEO globale.
Les profils qui en tirent le plus : les éditeurs de logiciels avec une documentation publique, qui veulent que les IA citent correctement leurs fonctionnalités quand un prospect demande « quel outil pour faire X ». Les e-commerces techniques, dont les fiches produit complexes deviennent lisibles sans le bruit des cross-sells et des avis. Les sites média et d’expertise, dont les articles deviennent ingérables par les pipelines d’agrégation IA. Et plus largement, toute marque dont le premier point de contact avec un prospect devient une IA plutôt que le site lui-même.
Questions fréquentes
C’est quoi, servir du Markdown aux IA ?
Servir du Markdown aux IA, c’est détecter qu’un crawler d’IA visite votre site et lui renvoyer une version Markdown propre de la page, au lieu du HTML complet destiné aux humains. L’IA reçoit le contenu sans le bruit du code, ce qui facilite sa lecture.
Est-ce que ça crée du duplicate content ?
Non. Les versions Markdown sont servies avec un en-tête noindex et un canonical qui pointe vers la page HTML. Google ignore ces URL pour son index classique, et l’autorité reste consolidée sur le HTML. Le SEO traditionnel n’est pas touché.
Ça ralentit mon site ?
Non. Le code ne s’exécute que pour les URL en .md ou pour les User-Agents de crawlers IA. Sur une visite humaine normale, le plugin reste inactif. Les conversions sont mises en cache vingt-quatre heures, invalidées à chaque modification d’article.
Ça marche avec Avada ou Elementor ?
Oui. Les shortcodes et blocs de page builder sont pré-rendus avant la conversion, donc c’est le rendu final qui est transformé en Markdown, pas le code brut de l’éditeur.
Comment être cité par ChatGPT et Perplexity ?
Le Markdown propre aide, mais ne suffit pas : il faut surtout des réponses directes en début de section, des définitions explicites et des titres qui posent la question. Je détaille la méthode sur ma page optimisation pour Perplexity. Ce mécanisme, je l’ai packagé dans un plugin que je développe et maintiens, WS Markdown for Bots, avec une licence unique sans abonnement. Voir le plugin.