Mis à jour le 12 octobre 2026
Un audit qui annonce 100 % de pages lentes mesure presque toujours la génération PHP d’une page froide, pas ce que vivent vos visiteurs. Sur WordPress avec LiteSpeed Cache, la même page peut sortir en 1 800 ms au premier accès et en 150 ms une fois en cache. Voici comment le vérifier en deux requêtes et le corriger durablement.
Je suis tombé dessus sur mon propre site : le rapport d’audit technique listait 258 pages « trop lentes (> 600 ms) », soit un taux d’erreur de 100 %. En mesurant en conditions réelles, le site répondait en 146 ms.
Pourquoi un audit remonte-t-il 100 % de pages lentes ?
Parce qu’un crawler d’audit visite chaque URL une seule fois et tombe donc sur la version non mise en cache, régénérée par PHP. Le délai mesuré est le TTFB (Time To First Byte), le temps avant le premier octet reçu. Sur une page Avada avec Rank Math, ce temps inclut de nombreuses requêtes en base de données.
Le crawler aggrave le problème : il parcourt le site à la chaîne et force beaucoup de régénérations proches dans le temps. Sur un serveur aux ressources limitées, elles se disputent le CPU, et chaque page gonfle d’autant. C’est le scénario qui produit un « 100 % » d’un coup.
Un repère utile : web.dev considère un TTFB de 0,8 seconde ou moins comme bon, et au-delà de 1,8 seconde comme mauvais, en précisant que ce sont des repères indicatifs et que le TTFB n’est pas l’un des Core Web Vitals. Le seuil de 600 ms de mon outil d’audit était donc plus strict que la référence de Google sur le sujet.
Quelle différence entre cache froid et cache chaud ?
Un accès à froid force WordPress à générer la page, un accès à chaud sert le HTML déjà stocké. Voici ce que j’ai relevé sur trois URL de mon site, premier accès puis deuxième accès immédiat.
| URL | 1er accès (froid) | 2e accès (en cache) |
|---|---|---|
| Page pilier | 1 802 ms | 148 ms |
| Article de blog | 1 670 ms | 191 ms |
| Accueil | 1 838 ms | 191 ms |
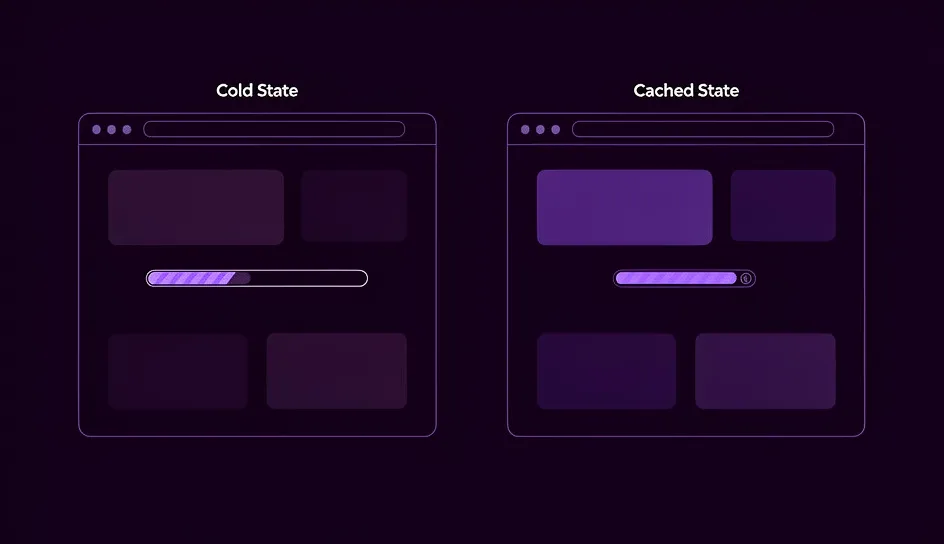
Le premier accès régénère la page, LiteSpeed stocke le résultat, le deuxième accès sert ce HTML prêt. Vos visiteurs récurrents touchent le plus souvent la version en cache. Le crawler d’audit, lui, ne voit que le démarrage à froid : c’est un artefact de méthode, pas un défaut de vos pages.
Comment savoir si c’est un faux positif chez vous ?
Mesurez le TTFB deux fois de suite sur la même URL : si le premier chiffre est élevé et le second nettement plus bas, le cache fait son travail. Voici la commande, à lancer deux fois (ou deux lignes à la suite) :
curl -s -o /dev/null -w "TTFB=%{time_starttransfer}sn" "https://votre-site.fr/une-page/"
curl -s -o /dev/null -w "TTFB=%{time_starttransfer}sn" "https://votre-site.fr/une-page/"
Pour confirmer que c’est bien le cache, regardez l’en-tête x-litespeed-cache. D’après la documentation LiteSpeed, hit signifie que la page vient du cache et miss qu’elle a été générée par le serveur. Si l’en-tête affiche miss en permanence, la documentation indique que quelque chose cloche (permissions, CDN intermédiaire, configuration).
curl -sI "https://votre-site.fr/une-page/" | grep -i x-litespeed-cacheTestez en visiteur déconnecté, sinon WordPress ne sert pas la version publique. Un crawler d’audit collectionne les miss.
Comment garder le cache chaud en permanence ?
Il faut préchauffer le cache pour qu’aucune page ne soit servie à froid. LiteSpeed Cache embarque pour cela un crawler interne qui lit votre sitemap, mais la documentation précise qu’il doit être activé au niveau du serveur ou de l’hôte virtuel. Sur certains hébergements, il est désactivé : le réglage paraît actif dans WordPress alors que rien ne tourne.
La parade que j’utilise est un cron qui parcourt le sitemap et requête chaque URL, avec une courte pause entre deux requêtes pour ne pas saturer le serveur.
#!/bin/bash
SITEMAP="https://votre-site.fr/sitemap_index.xml"
UA="Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/124.0 Safari/537.36"

subs=$(curl -s -A "$UA" "$SITEMAP" | grep -oE '<loc>[^<]+</loc>' | sed -e 's/<loc>//' -e 's#</loc>##')
for sm in $subs; do
  curl -s -A "$UA" "$sm" | grep -oE '<loc>[^<]+</loc>' | sed -e 's/<loc>//' -e 's#</loc>##'
done | sort -u | while IFS= read -r u; do
  curl -s -o /dev/null -A "$UA" "$u"
  sleep 0.7
done
Je le planifie deux fois par jour, ce qui suffit quand la durée de vie du cache est de plusieurs jours. La valeur par défaut du TTL public dans LiteSpeed Cache est de 604 800 secondes, soit une semaine :
0 0,12 * * * /bin/bash /chemin/vers/cache-warm.shSur mon site, le premier passage a régénéré 199 pages sur 236. Le passage suivant en trouvait 235 déjà en cache et aucune à régénérer.
Faut-il aussi vérifier l’object cache et OPcache ?
Oui, car ces deux réglages pèsent sur le démarrage à froid. L’object cache est désactivé par défaut dans LiteSpeed Cache, qui se connecte à un Memcached ou à un Redis externe. S’il pointe vers un service absent de votre hébergement, chaque génération de page peut perdre du temps à tenter une connexion qui échoue.
Pour savoir si Redis répond sur votre serveur (en SSH) :
redis-cli -h localhost -p 6379 pingUne réponse PONG signifie que Redis tourne. Une erreur de connexion signifie qu’il faut désactiver l’object cache dans LiteSpeed Cache (onglet Object).
OPcache est le cache d’opcode de PHP : bien réglé, il évite de recompiler le code à chaque requête. Sur mon serveur, il tournait à 99,8 % de succès avec 256 Mo alloués, donc rien à corriger. Pour vérifier le vôtre, utilisez une page phpinfo() temporaire (section Zend OPcache) et supprimez-la aussitôt : laissée en ligne, elle expose votre configuration serveur.
Que faire une fois le cache préchauffé ?
Relancez l’audit. Le crawler tombe alors sur des pages déjà en cache, et le taux de pages lentes s’effondre. Voici la marche à suivre :
- Mesurer deux fois le TTFB d’une même URL avec curl.
- Lire l’en-tête
x-litespeed-cachepour distinguerhitetmiss. - Vérifier que le crawler LiteSpeed tourne vraiment, sinon installer le cron de préchauffage.
- Contrôler l’object cache (Redis ou Memcached présent ou non) et OPcache.
- Relancer l’audit après un passage complet du cron.
Ma règle : un score d’audit alarmant mérite une contre-mesure manuelle avant de réécrire 250 pages. Deux requêtes curl m’ont évité un chantier inutile.
Questions fréquentes
Pourquoi un audit indique-t-il 100 % de pages lentes alors que mon site WordPress est rapide ?
Parce que le crawler visite chaque URL une seule fois et tombe sur la version froide, régénérée en PHP, jamais sur la version en cache. Sur mon site, le TTFB à froid atteignait 1 800 ms alors que la même page sortait à 150 ms une fois en cache.
Comment vérifier si une page WordPress est servie depuis le cache LiteSpeed ?
Inspectez l’en-tête HTTP x-litespeed-cache, par exemple avec curl -sI suivi de l’URL et d’un grep sur le nom de l’en-tête. La valeur hit indique que la page vient du cache, miss qu’elle a été générée côté serveur. Testez en visiteur déconnecté.
Comment garder le cache LiteSpeed chaud sur un hébergement limité ?
Planifiez un cron qui parcourt votre sitemap et requête chaque URL deux fois par jour, avec une courte pause entre deux requêtes. Sur mon site de 236 pages, un passage a fait passer les régénérations de 199 à zéro.
Faut-il activer l’object cache Redis avec LiteSpeed ?
Seulement si votre hébergement fournit un Redis ou un Memcached joignable. Testez avec redis-cli ping : sans réponse PONG, désactivez l’object cache pour éviter une tentative de connexion ratée à chaque génération de page.
Le TTFB compte-t-il pour le référencement ?
Il influe sur le chargement mais n’est pas l’un des Core Web Vitals, selon web.dev. Il vaut mieux surveiller le temps réel vu par vos visiteurs que le chiffre d’un crawler qui ne voit que le cache froid.